
HiRoute:Jev 模型智能路由实践
长程 Agent 任务通常包含不同性质的工作:整理资料、设计方案、实现代码、核验结果。全部交给强模型容易增加成本,全部交给经济模型又可能在关键判断上出错。仅按输入长度选模型,也无法识别“材料很多,但只需直接摘录”和“输入很短,却要求推导系统保证”的差别。
HiRoute 把 Jev 放在模型调用之前,判断当前任务所需的能力,并在后续决策机会评价此前阶段的执行表现。Jev 返回结构化判断,HiRoute 根据已发布的路由策略选择执行模型,原有 Agent 继续负责读文件、调用工具和完成交付。
本文结合公开实现和实验,介绍怎样把分类、复杂度和胜任度组合成可观测的路由闭环,以及怎样核对其真实收益。文中的配图可点击放大,产品截图的细节可在预览中查看。
1. 把判断接到现有 Agent 工作流
HiRoute 是运行在本机的开源路由引擎,Desktop 与 CLI 共用本地 Gateway。Agent 使用一份稳定的路由计划,背后的执行模型可以按工作阶段变化。
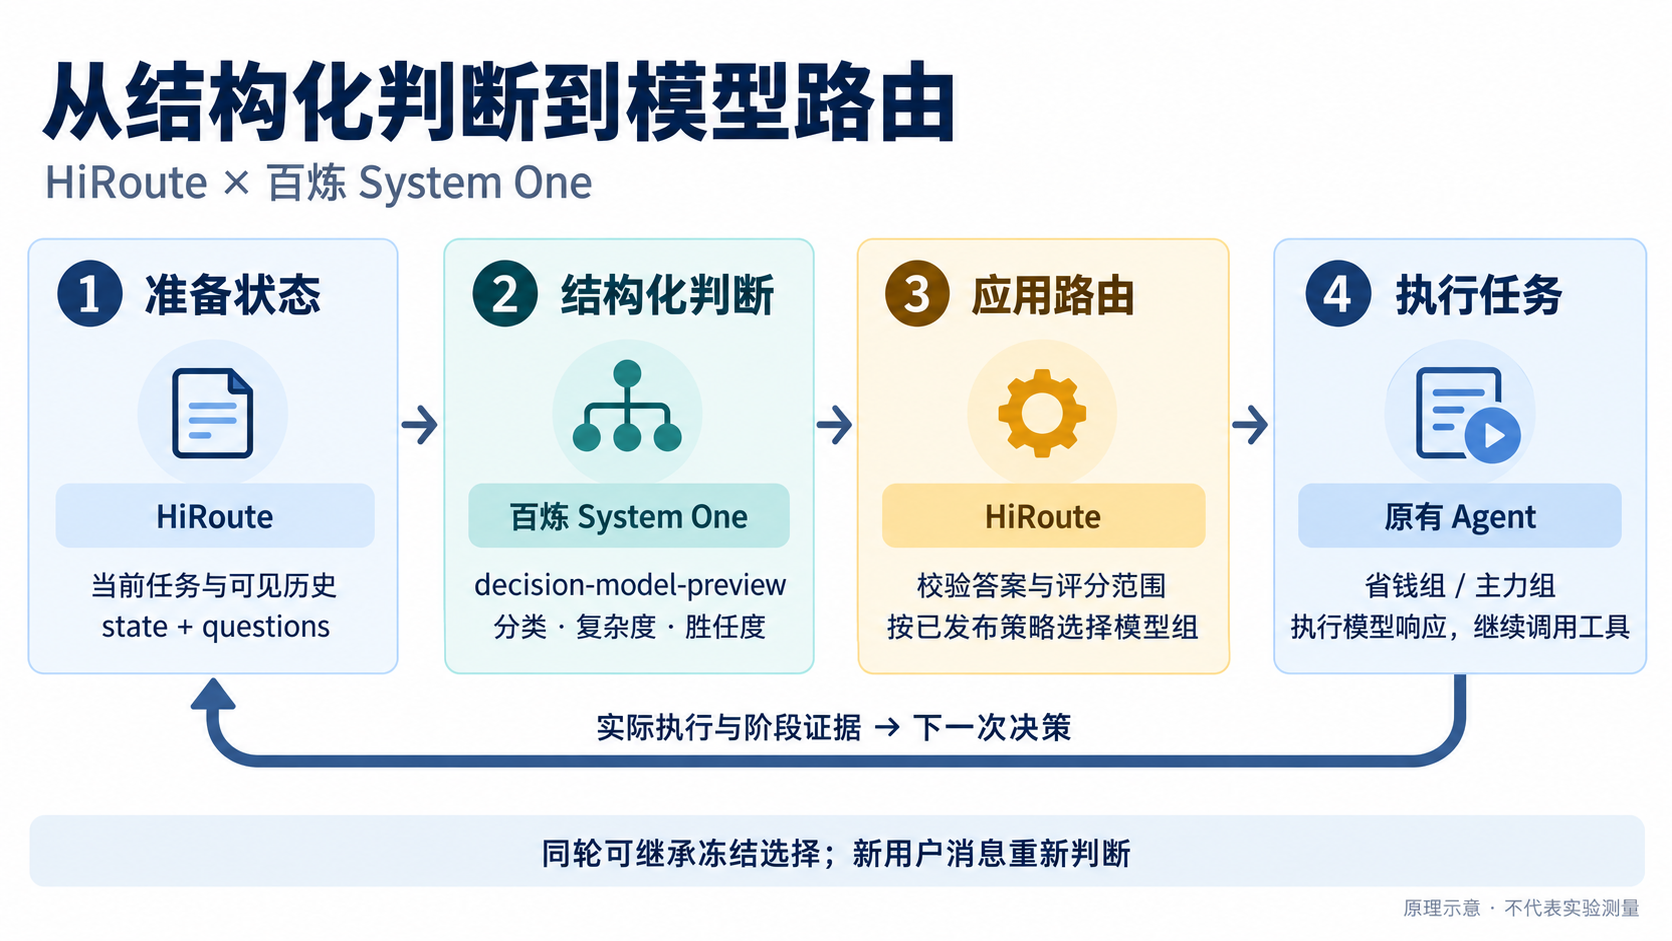
图 1:结构化判断与模型执行的闭环。原理讲解图,非产品截图或实验测量。
图中的反馈发生在需要重新决策的请求上。同一轮中可识别、可继承冻结决策的工具续接复用已有选择;新用户消息重新判断。这样既能调整能力,也能避免每次工具调用都额外请求 Jev。
有两种接入方式:
| 方式 | 用法 | 适用场景 |
|---|---|---|
| 内置决策模型 | 在 HiRoute 中保存百炼 System One 连接,由内置适配器构造问题和转换答案 | 直接配置路由 |
| 自定义扩展 | 部署参考 HTTP 服务,接收 HiRoute 决策请求,再调用 Jev | 自行管理服务或修改供应商集成 |
两种方式都遵循相同分工:决策模型提供判断,HiRoute 执行策略,执行模型完成任务。 阈值、模型组、故障接力和记录身份由 HiRoute 管理;Jev 的答案不会直接指定模型凭据或替代执行授权。实现与配置说明
2. 分开提出三个问题
路由时,下面三个问题需要分别定义:
| 问题 | Jev 问题类型 | HiRoute 消费的结果 |
|---|---|---|
| 当前做什么?例如写稿、审稿 | Choice | 任务类别,选择分支 |
| 当前工作需要多强的能力? | Score | 各复杂度档位的概率,在分支内选择模型组 |
| 上一实际执行阶段做得如何? | 独立的 Score | 按冻结评分标准计算的胜任度 |
“智能省钱”只有一个任务范围,配置省钱组和主力组,不需要再把简单、复杂建成两个任务类别。“自定义分支”先选择任务类别,再判断该类别内的复杂度;只配置一个模型组的类别无需复杂度问题。
2.1 按工作要求定义复杂度
在公开的消息系统调研实验中,简单工作包括从既有资料提取、归类、翻译、核对引用和规范格式。复杂工作包括处理冲突材料、分析多个系统组合后的保证,以及推导故障顺序与副作用。
这种定义把判断落在所需推理上:输出很多条目不自动等于复杂;有引用、语气自信也不自动等于结论正确。条件应描述任务要求,并允许保留不确定性。实验使用的完整条件
2.2 一次调用,问题彼此独立
Jev 的同次请求可以包含多个问题,但不能要求一个问题读取另一个问题尚未返回的答案。自定义分支因此一次提交类别问题,以及各双组类别的假设性复杂度问题,随后只读取选中类别的复杂度。
例如,写稿与审稿都配置两组模型时,可以问:
- 当前主要意图属于写稿还是审稿?
- 假设交给写稿分支,所需工作有多复杂?
- 假设交给审稿分支,所需工作有多复杂?
- 如果有可靠的评分目标,上一实际阶段完成得如何?
若选中审稿,就读取第 3 个答案。第 2 个答案缺失不影响该路径;第 3 个答案无效时,保留审稿类别并使用其主力组。评分仍绑定已经发生的阶段:上一阶段是写稿,就评价写稿,不因当前选择审稿而改变评分对象。问题映射与归约
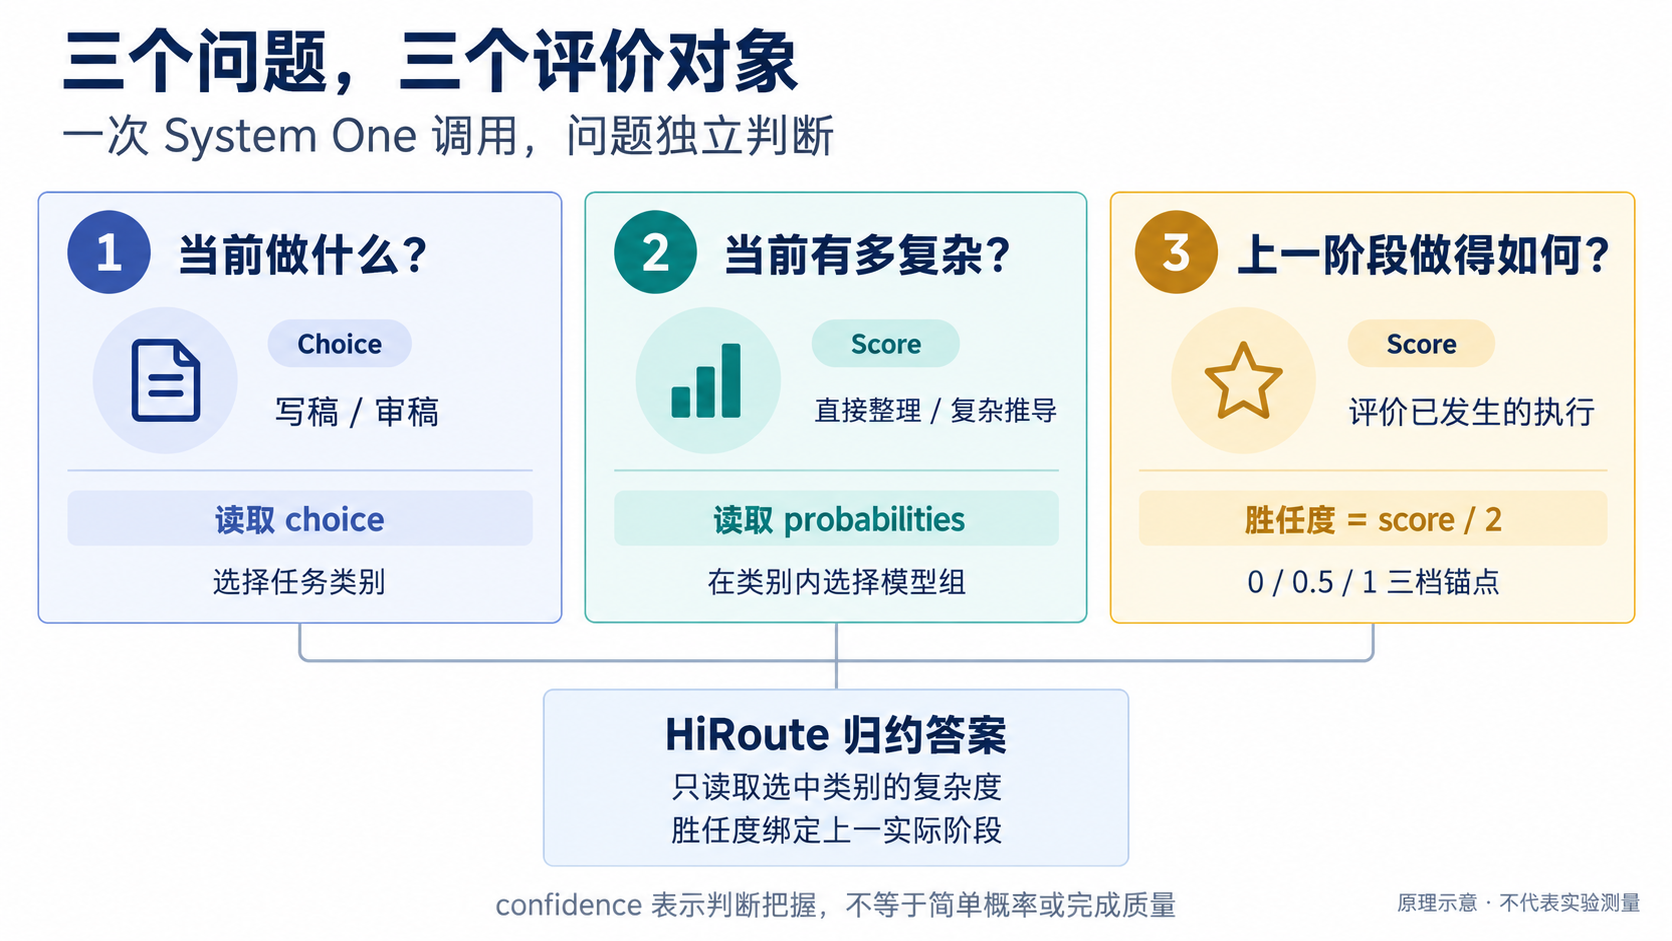
图 2:三个问题对应不同评价对象。HiRoute 在答案返回后归约,问题之间不互读结果。
2.3 概率、评分和置信度分别使用
复杂度取完整概率分布中的简单档概率,不把 confidence 当成简单概率,也不把任意量表的 score 或 1-score 当成通用替代值。
胜任度采用 0 / 0.5 / 1 三个等距锚点。对应的 System One Score 返回 0–2 范围内的值,适配器用原始 score / 2 转为 HiRoute 的 0–1 范围。confidence 表示答案的不确定性,不能代替工作完成质量。
下面采用百炼 System One API,模型为 decision-model-preview。示例使用 Token Plan 个人版接入点,需要对应的套餐 API Key(sk-sp- 前缀);将自己的密钥配置到环境变量 DASHSCOPE_API_KEY。使用业务空间时,按 API 参考换成含 {WorkspaceId} 的地域域名,并使用该业务空间的 API Key。百炼 API 参考、Token Plan 接入说明
这是精简示意请求。文本与响应数值用于解释映射,并非实验实测结果,也不是 HiRoute 自定义扩展的入站 JSON:
{
  "model": "decision-model-preview",
  "state": {
    "latest_user": [{"kind": "text", "text": "根据已提供的资料,补齐来源表格。"}],
    "visible_conversation": [{
      "user": [{"kind": "text", "text": "整理材料中的主要结论及引用。"}],
      "status": "completed",
      "steps": [[{"kind": "text", "text": "已输出表格,但两条关键结论缺少来源支撑。"}]]
    }],
    "history_partial": false,
    "assessment_from": 0
  },
  "questions": {
    "q0": {
      "type": "score",
      "instructions": "只判断 state.latest_user 所要求的当前工作,不评价历史执行表现。",
      "criteria": [
        "资料充分,可直接提取、核对和格式化已有事实。",
        "需要推导新结论、解决冲突或分析复杂故障交互。"
      ]
    },
    "q1": {
      "type": "score",
      "instructions": "评价 state.visible_conversation 从 state.assessment_from 开始的已执行阶段,不评价尚未执行的当前任务。",
      "criteria": [
        "关键事实失真、缺少进展或需要大幅纠正。",
        "已有可用成果,但存在明显遗漏或证据问题。",
        "事实与引用准确,完成该阶段要求。"
      ]
    }
  }
}
将上述 JSON 保存为 decision-request.json,通过 HTTP 调用:
curl --fail-with-body -sS \
  -X POST 'https://token-plan.cn-beijing.maas.aliyuncs.com/compatible-mode/v1/systemone' \
  -H "Authorization: Bearer $DASHSCOPE_API_KEY" \
  -H 'Content-Type: application/json' \
  --data-binary @decision-request.json
精简响应:
{
  "answers": {
    "q0": {"type": "score", "score": 0.09, "probabilities": {"0": 0.91, "1": 0.09}},
    "q1": {"type": "score", "score": 0.96, "probabilities": {"0": 0.04, "1": 0.96, "2": 0}}
  }
}
这里的简单概率为 0.91,上一阶段胜任度为 0.48。前者允许使用省钱组,后者可能触发保护性升级;是否升级还要检查评分是否完整、是否适用于同一类别和计划版本。首次请求没有评分目标,只提交复杂度问题。
3. 把答案变成明确的路由规则
当前实现的双组选择可以概括为:
| 条件 | 选择 |
|---|---|
| 简单概率低于阈值 | 主力组 |
| 简单概率达到阈值,且存在本次适用的完整低分 | 主力组 |
| 简单概率达到阈值,且没有上述低分 | 省钱或常规组 |
| 类别有效,但所需复杂度答案无效 | 该类别的主力组 |
默认简单概率阈值为 0.8,胜任度下限为 0.5。这两个参数是策略设置,不是 Jev 的固定能力指标。
低分保护只使用对上一实际阶段的本次新评分,并核对类别、已发布计划版本和评分标准。写稿的低分不能使审稿类别升级;过去保存的低分不会反复作为新低分。评分缺失保持未评分,部分证据评分保留标记,二者均不当作零分触发保护。
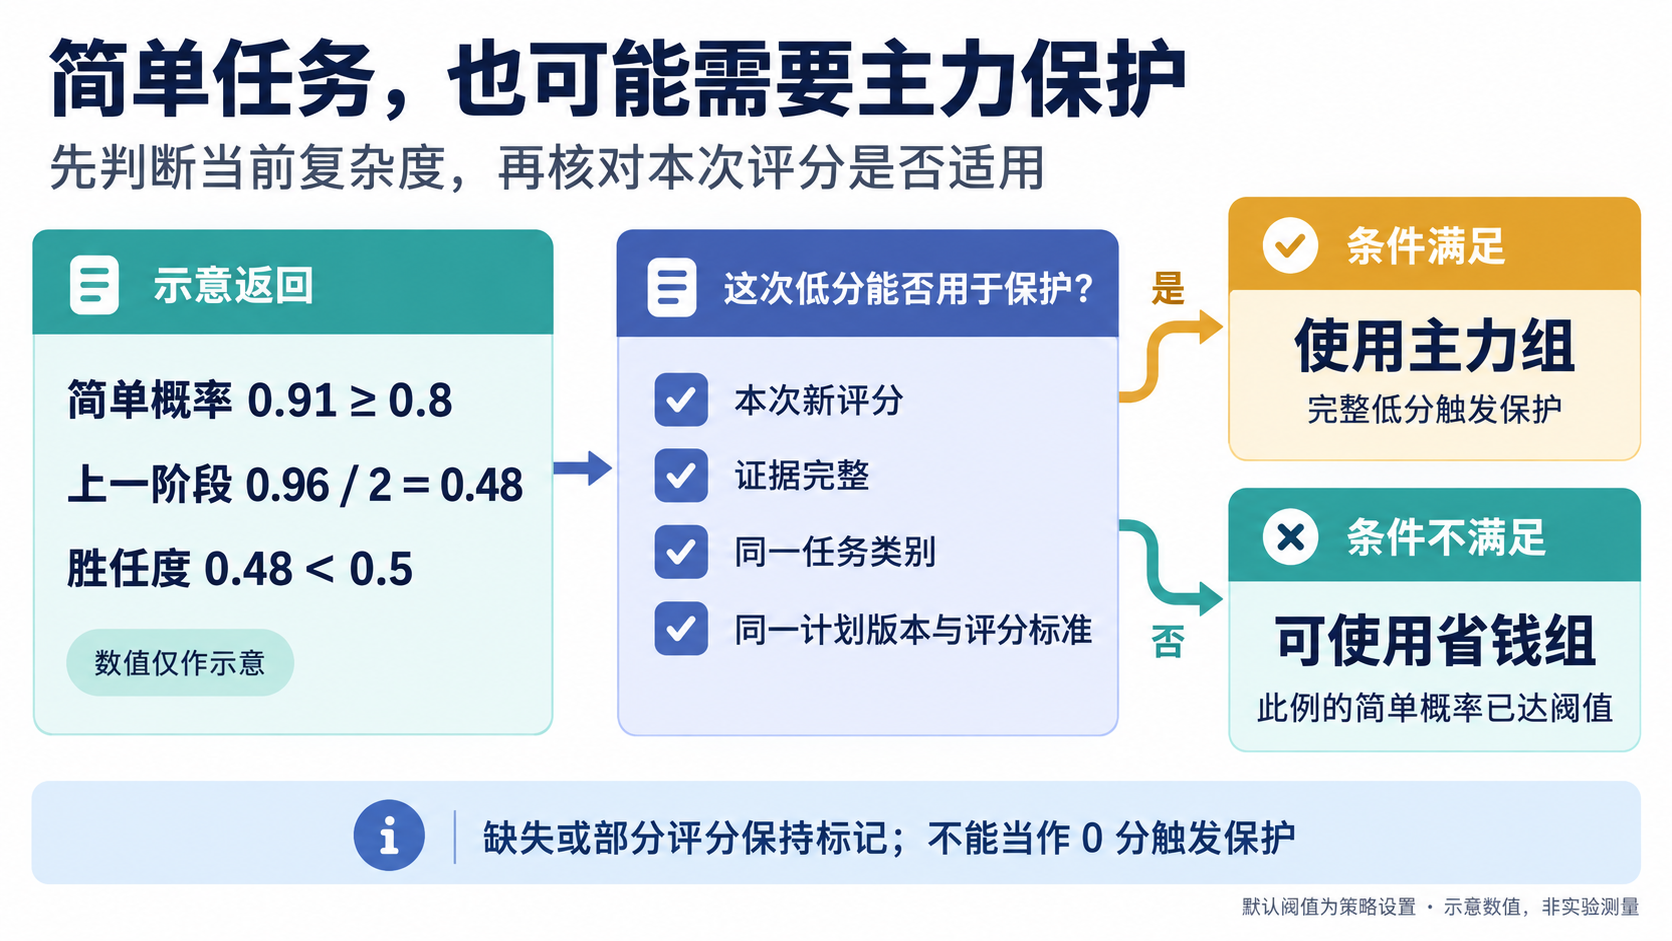
图 3:前述示意响应的消费方式。阈值可配置;评分不适用时,此例仍可按已达阈值的简单概率选择省钱组。
这也允许模型回切:每条新用户消息重新判断,在当前组内选择合格候选。省钱或常规组因候选不可用而接力主力组,则属于可用性接力,应与因任务复杂或胜任度低而选主力分别记录。当前组选择实现
工程边界要随结果一起保留
在 Jev 参考扩展中,一次决策只发一次上游调用。请求总超时包含准备、并发排队、连接和读取,不会自动重试;当前输入与问题保持完整,必要时从最旧完整历史轮次开始裁剪。裁到评分目标时标记部分评分,目标全部移除时省略评分,当前输入本身超限则拒绝请求。
整体决策失败时,智能省钱使用其启发式回退;自定义分支使用默认类别,有主力组则优先使用主力。因此,“计划里配置了谁”与“实际执行了谁”必须分别核对。日志和观测记录保留耗时、状态、实际模型、用量及评分覆盖范围,避免只看 HTTP 成功或一个评分数字。参考扩展的行为与限制
4. 公开实践:分别验证成本、接力和质量
4.1 消息系统调研:把强模型用在关键判断
任务包含六种消息系统的资料核验,每种 60 张来源卡片,再完成一份 Kafka/SQL 一致性决策备忘录。三种模式使用相同资料与要求:全 GPT-6 Astra、Qwen-3.8 Flash 与 Astra 混合、全 Qwen,各三次交付。
混合模式把直接资料整理交给 Qwen,把关键方案判断交给 Astra。原定整单验收要求覆盖全部 360 张卡片、至少 353 张正确,且关键备忘录完全正确。
| 原始评价口径,含引用支撑 | HiRoute 混合 | 全 Astra | 全 Qwen |
|---|---|---|---|
| 三次合计卡片正确率 | 98.61%(1,065/1,080) | 99.72%(1,077/1,080) | 98.80%(1,067/1,080) |
| 无重大错误的关键备忘录 | 3/3 | 3/3 | 1/3 |
在双方均达到原定整单门槛的第 2、3 对运行中,混合模式的保守成本降幅分别为 92.01%、91.39%。计算采用 1 - 混合成本上界 / 全 Astra 成本下界,包含受试尝试、结构性重试及已报告的 Jev 成本。
第 1 次混合交付的卡片数为 352/360,未达到 353 的门槛,其支出保留但不计入达标交付节省。全 Qwen 第 3 次发生传输恢复,失败请求成本未知;完成产物可评价,但不能把全部尝试成本补零。
这些是冻结的 API 等价美元成本,不是订阅账单。三次重复的特定任务、非盲评价和两组达标比较,支持这个案例中的工作分配方法;不证明普遍节省比例、统计质量等价或更快完成。完整方法、全部结果与成本边界
4.2 长程编码:反馈能改变下一阶段的能力
另一项任务要求原生 Codex 为 HTTPX 增加同步与异步 JSON 流式迭代。一次初始指令后,没有中途人工提示或人工产品代码补丁,实际模型顺序为 Qwen → Astra → Qwen → Astra。
| 阶段 | 记录到的工作与反馈 |
|---|---|
| Qwen 起步 | 阅读源码和测试,进行接口探查 |
| 首次切到 Astra | 上一阶段评分 0.41,低于 0.5;本次 Astra 请求用于上下文摘要 |
| 回到 Qwen | Astra 摘要阶段评分 0.775,历史经济优先策略允许 Qwen 接续 |
| 再次切到 Astra | 后续仍在研究,评分 0.485;Astra 接续实现、测试和修复 |
任务耗时约 31 分 36 秒,最终独立验收通过 108 项功能、229 项回归、6 项增量性断言,共 343 项。三次换模发生在两次原生上下文压缩及相邻决策机会,不能写成三次压缩。摘要评分 0.775 评价的是摘要,不能解释为 Qwen 已经胜任剩余实现。
这是 2026-10-04 公开的历史运行,其决策保留了部分历史标记。当前版本的低分保护要求适用的完整评分,不能把历史保护行为当作当前版本在部分证据下也会升级的证明。这个案例证明实际发生过自动接力并完成交付;中间每次选择是否最优,仍需另外评价。请求顺序、评分对象与独立验收
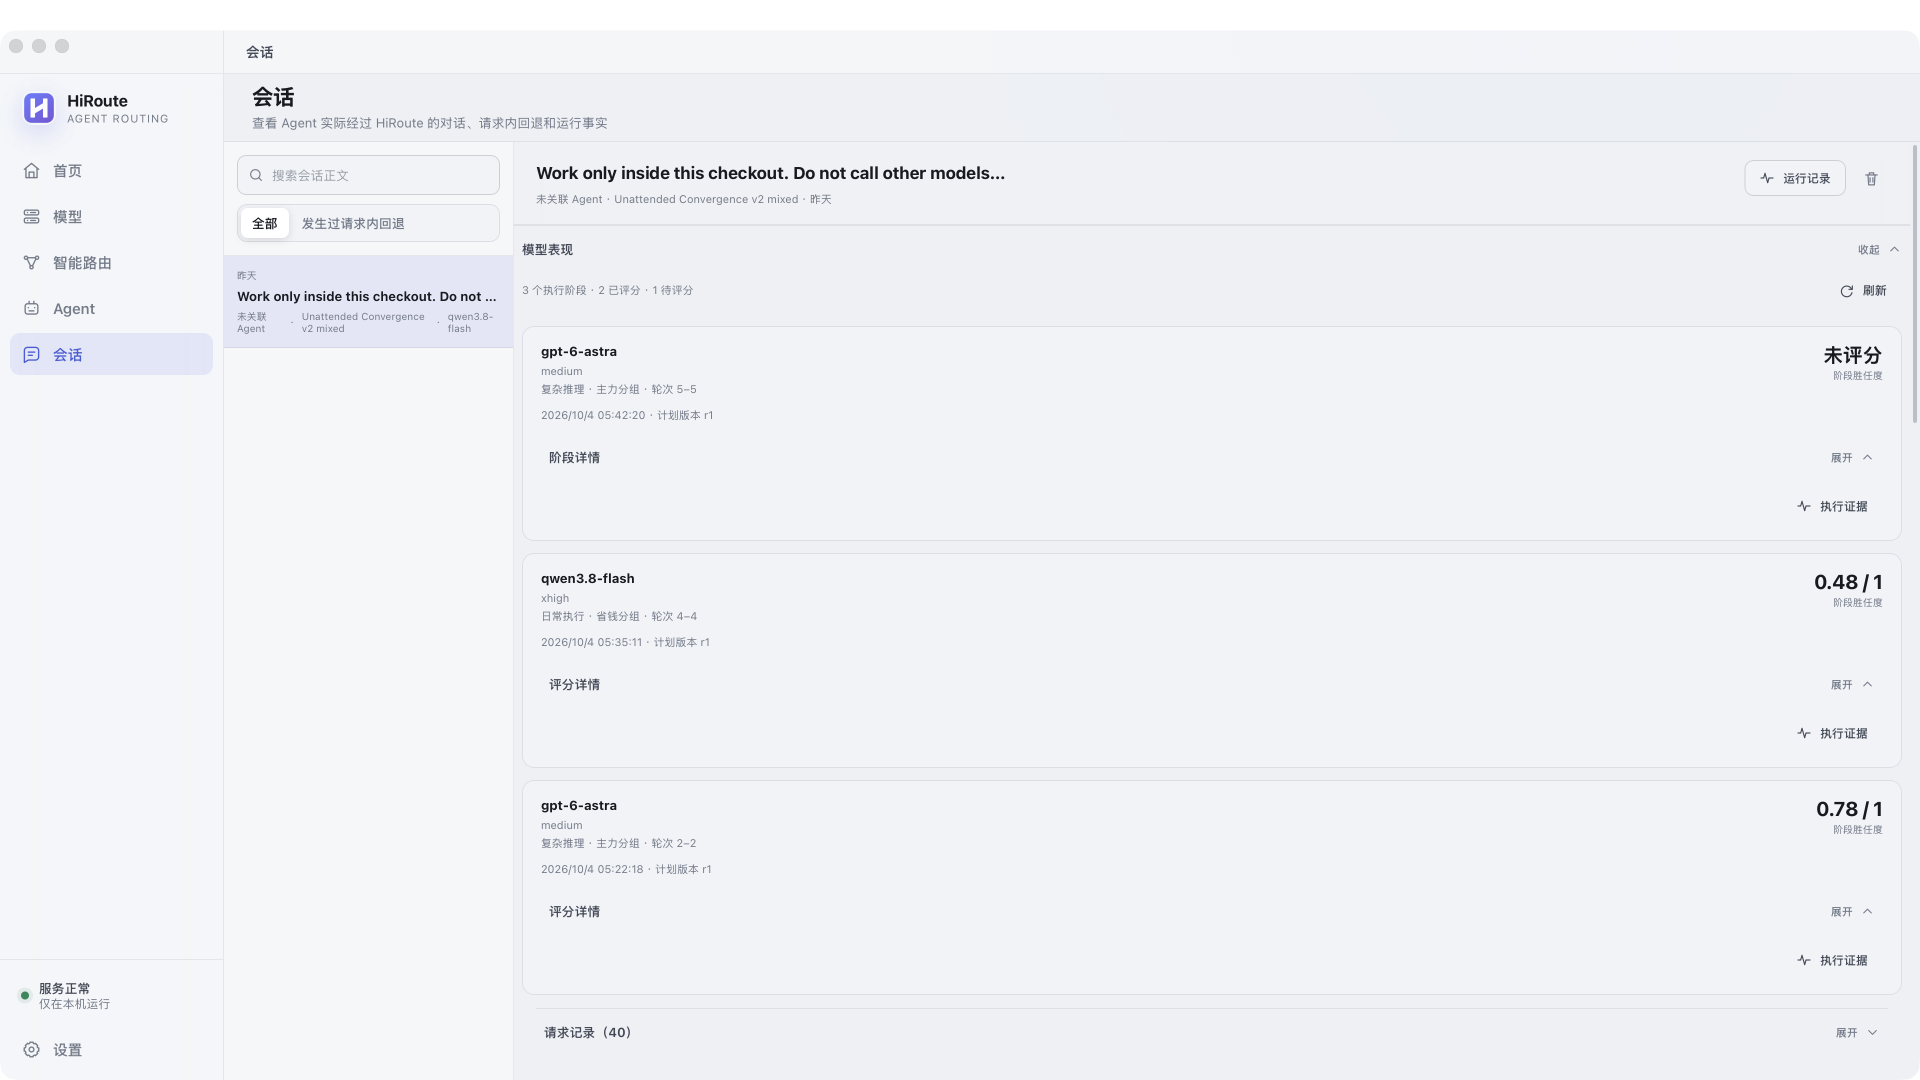
图 4:macOS 原生 HiRoute Desktop 截图,2026-10-05 捕获。产品读取隔离副本中的原始 HTTPX 观测记录,原始阶段与评分保持不变;这是历史数据回放,并非实验当场截图或新一轮模型评测。
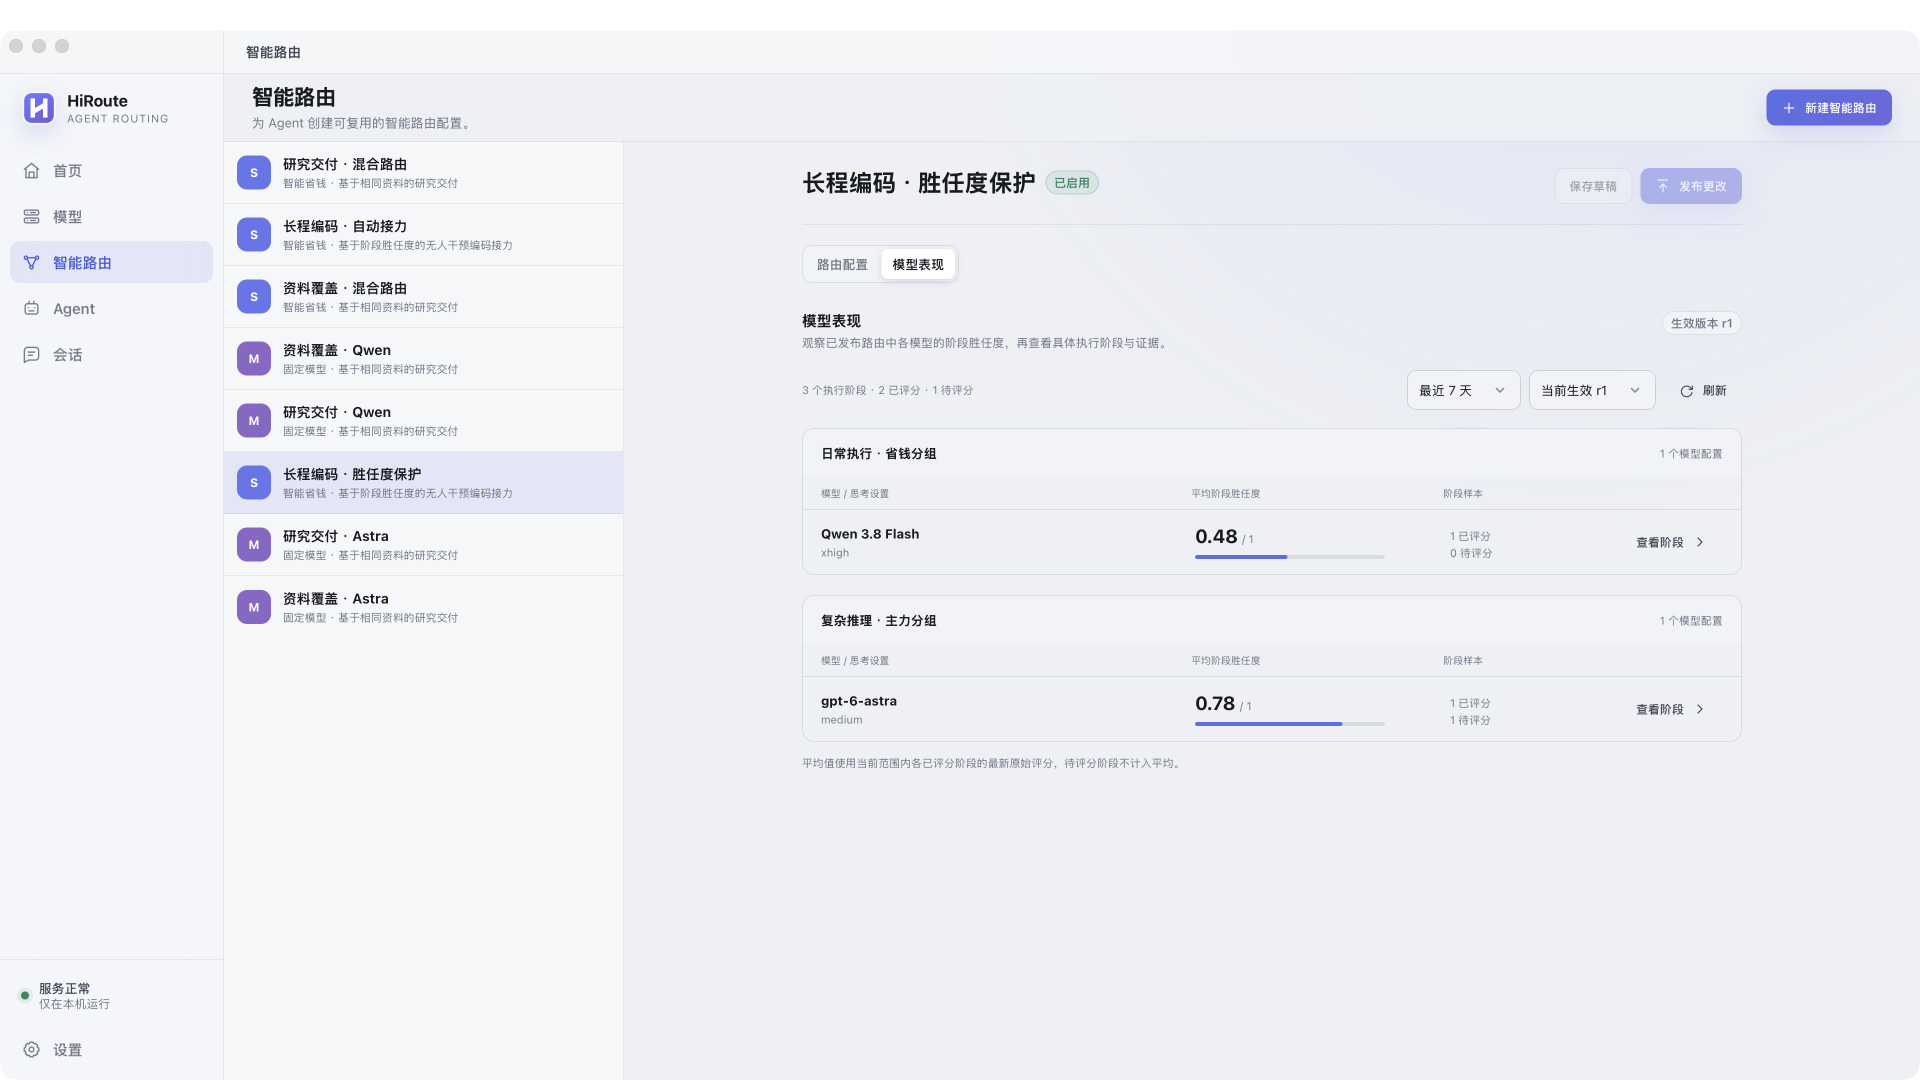
图 5:同次原生捕获的计划汇总。原始 0.485、0.775 在界面中显示为 0.48、0.78;Astra 最终阶段仍未评分,不计入平均分。两种模型的分数来自不同工作阶段,不能当作同任务排名。截图来源与捕获记录
4.3 后续实验:路由评分需要独立评价
2026-10-06 的写稿/审稿实验中,Qwen 写稿、GLM 审稿的混合分工没有显示质量增益。两次初审入口发生 Jev 超时,后续分别有 6、9 个请求继承 Writing 回退,实际使用 Qwen;这不是 15 次独立超时。
同一轮实验中,某个修订阶段胜任度为 0.935,文章的独立盲评仍只有 65 分。另一个智能省钱完整样本全程使用 Flash,通过全部功能检查,却没有自然升级。这些结果说明:胜任度是路由信号,交付质量和升级效果需要独立验证。 全部登记结果及局限
5. 从最小配置开始复现
5.1 配置一个双组计划
- 在 HiRoute 的“模型 → 决策模型”添加连接,选择 百炼 Token Plan,核对完整端点
https://token-plan.cn-beijing.maas.aliyuncs.com/compatible-mode/v1/systemone、模型decision-model-preview和自己的套餐 API Key,保存并测试连接。使用按量业务空间时,改选“百炼业务空间”,按官方文档填写带业务空间 ID 的完整地域接入点。 - 建立“智能省钱”计划,选择该连接,在省钱组和主力组中分别配置可用执行模型。
- 按自己的任务定义简单/复杂条件与胜任评分锚点,先固定阈值,再开展代表性任务测试。
- 发布计划,将其接入现有 Agent;观察实际组、实际模型、选择原因和后续阶段评分。
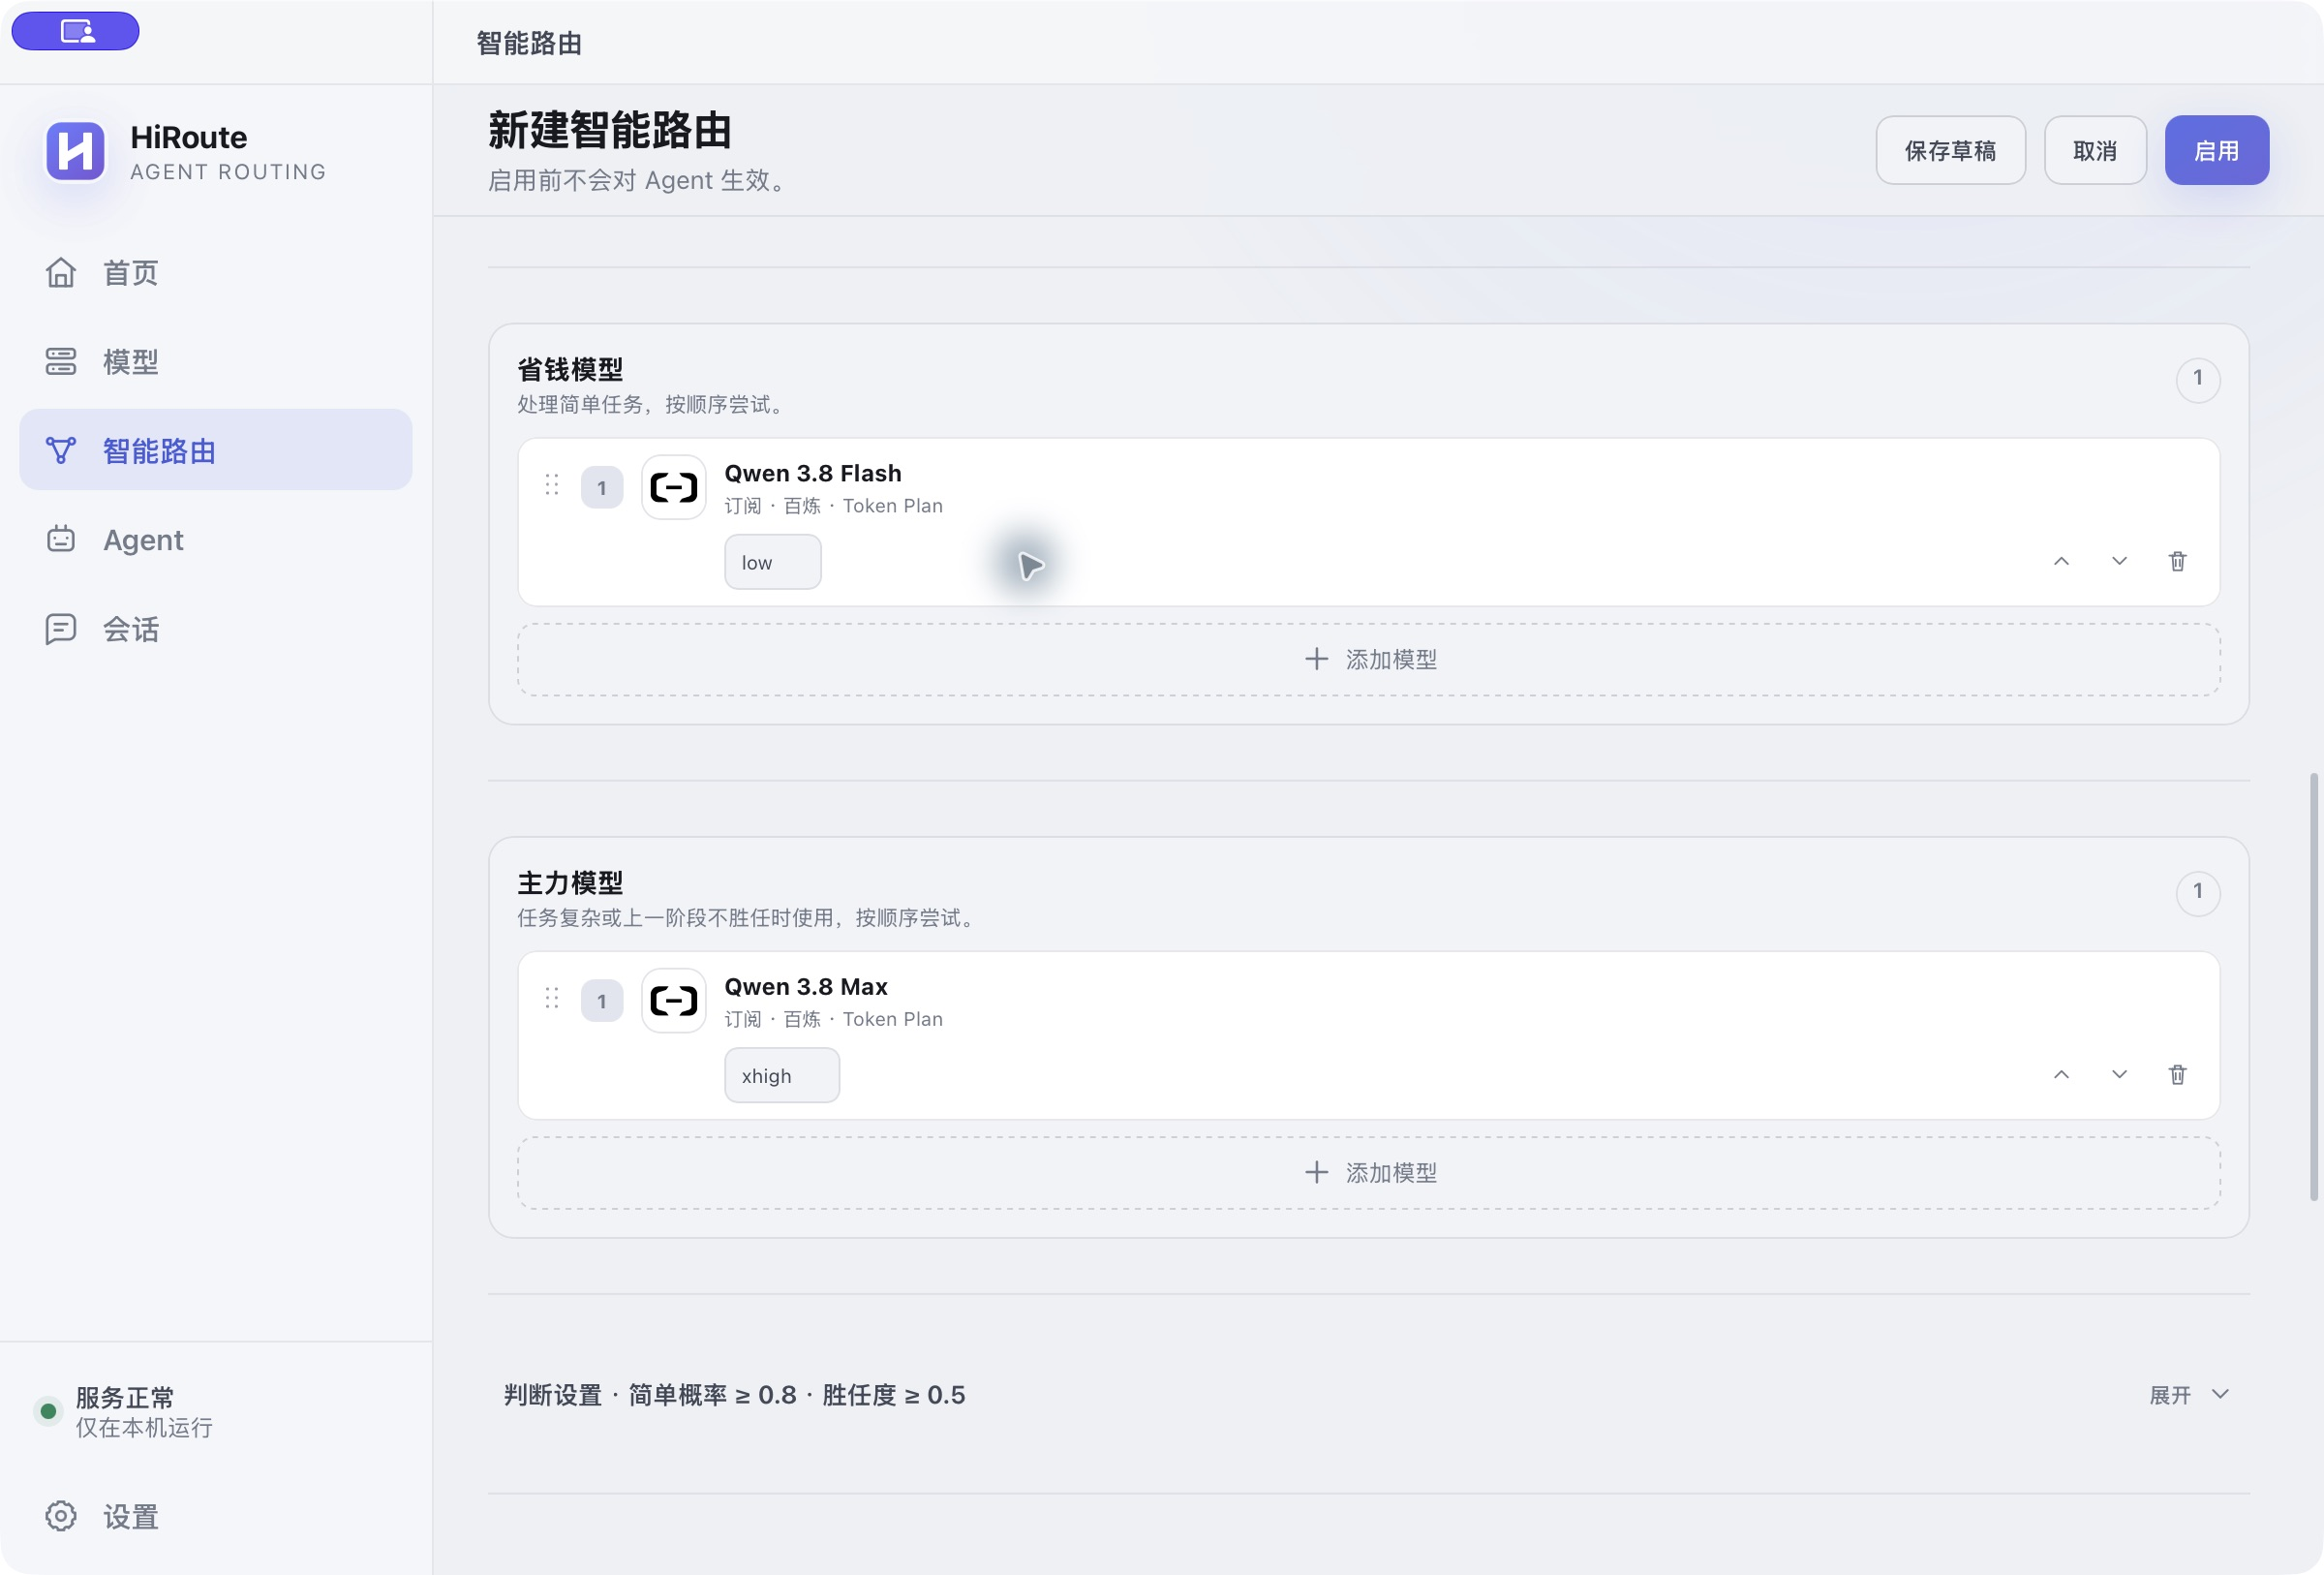
图 6:2026-10-08 的 macOS 原生产品截图,展示尚未保存或启用的双组配置。图中 Flash / Max 是执行模型示例;决策连接另选百炼 System One,和第 4 节历史实验的 Qwen / Astra 组合分别理解。截图来源说明
连接测试使用合成输入验证传输和必要字段,不等于实际任务判断准确。需要修改供应商集成时,可以部署可独立安装的 Jev 参考扩展,其 HiRoute 入站地址为 /v1/decisions;上面的 System One 地址是供应商端点,二者使用不同 JSON。
5.2 先离线核对历史证据
在 HiRoute 仓库根目录,使用 Python 3.11+ 执行:
python3 experiments/reproduce.py fetch
python3 experiments/reproduce.py verify
python3 experiments/reproduce.py report
fetch 下载冻结证据并核对归档校验和,verify 核对原始文件和已登记结果,report 重新计算原定门槛与成本。这些步骤不会调用付费模型。它们重放已公开的非盲评价记录,不能替代一次独立语义审查;2026-10-06 的原始文章和完整观测资料也不在这份归档中。复现入口与证据范围
开展新的付费运行时,应使用自己的服务,提前登记任务、对照组、顺序、验收规则、重试策略和费率,保留失败与未知成本。最后按真实回执核对实际模型和所有尝试,再独立审阅产物。这样才能区分决策质量、执行模型质量、传输失败和记录缺口。
6. 可迁移的实践方法
- 把问题落在业务语义上。 分类描述当前意图,复杂度描述所需推理,胜任度评价已发生的工作;每个问题注明评价对象。
- 用确定代码消费结构化答案。 保留概率分布,校验允许值,明确超时和缺失结果的回退策略,并冻结发布版本。
- 让反馈绑定具体阶段。 同时检查类别、评分标准和证据覆盖;记录选择理由与实际执行,便于解释换模和回切。
- 以整单交付衡量收益。 预先固定验收门槛,计入决策调用和失败尝试,保留未达标样本,独立检查内容质量。
实现核对版本为 HiRoute 公共仓库的 5232db559bb8e856d44549d5e1488c7cf4f78d83。本文接入示例以 百炼 System One API 和 Token Plan 接入说明 为准;历史实验的模型、端点、参数和结果仍以各自冻结记录为准。